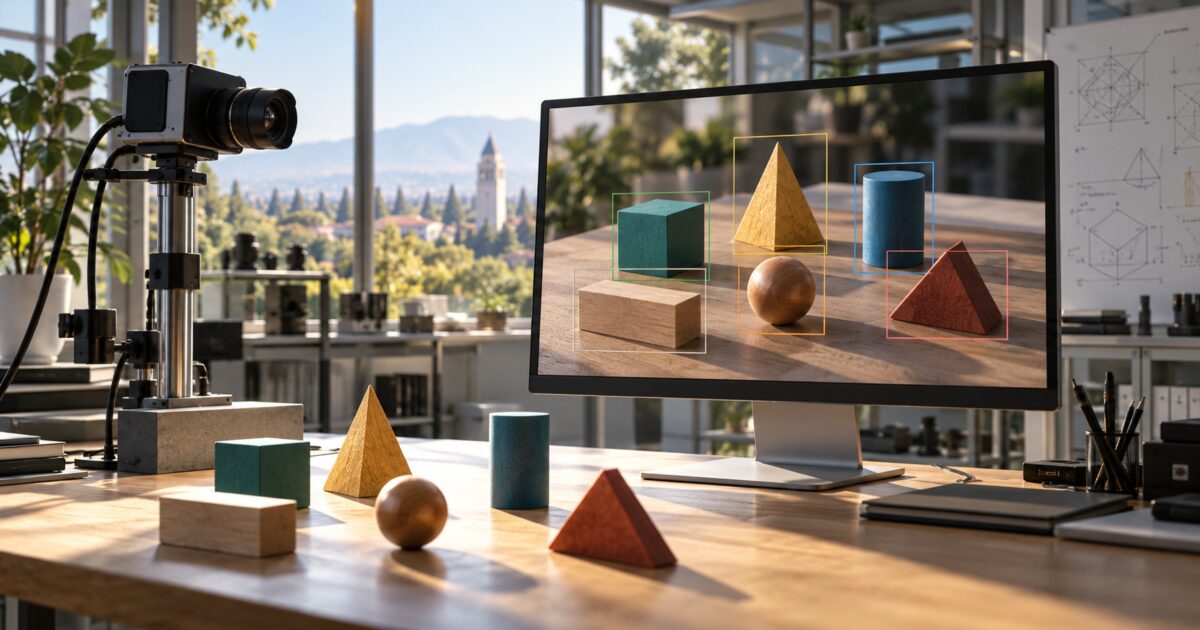
A Elorian apresentou em 16 de outubro o Glimpse, um modelo de inteligência artificial voltado ao raciocínio visual, disponível como prévia de pesquisa por API e interface de conversa. A proposta é permitir que o sistema volte às evidências de uma imagem ou de um vídeo durante a análise, em vez de depender exclusivamente de uma descrição inicial para produzir a resposta.
O lançamento coloca em discussão uma diferença importante: reconhecer elementos em uma cena não é o mesmo que compreender suas relações. Identificar uma ferramenta, por exemplo, pode ser apenas o primeiro passo. Entender se ela está sendo usada corretamente, como se move e qual consequência uma ação pode produzir exige acompanhar informações que nem sempre cabem bem em uma descrição textual.
Como o Glimpse trabalha com evidências visuais
No anúncio do Glimpse, a Elorian descreve um sistema que revisita representações visuais e utiliza ferramentas para examinar imagens e vídeos. Entre os exemplos divulgados estão acompanhar objetos em movimento, mudar a perspectiva da análise e observar trechos específicos de uma sequência. São demonstrações da empresa, e não testes independentes realizados pelo Vale do Silício.
A ideia pode ser entendida por uma comparação simples. Ao tentar contar veículos em uma gravação, uma pessoa pode pausar o vídeo, voltar alguns segundos e verificar se um carro já havia aparecido. Uma análise que considere essas etapas tem condições de evitar a contagem duplicada. O exemplo ilustra o tipo de problema; não significa que qualquer vídeo será contado corretamente pelo modelo.
Também existe uma diferença entre detectar movimento e acompanhar identidade. Dois objetos parecidos podem se cruzar, sair do enquadramento ou ficar parcialmente escondidos. Para responder de maneira consistente, um sistema precisa relacionar observações em momentos diferentes. Essa continuidade é uma parte relevante do raciocínio visual, especialmente quando o objetivo vai além de produzir uma legenda aproximada.
Entender imagens é diferente de gerar imagens
Na apresentação de sua linha de pesquisa, a Elorian distingue geração de conteúdo visual e compreensão de relações espaciais. Produzir uma imagem convincente não demonstra, por si só, que um modelo consiga interpretar a posição de cada objeto ou prever corretamente uma interação física. A empresa considera essa diferença central para o desenvolvimento de sistemas úteis no mundo real.
Essa distinção ajuda a evitar uma confusão comum na discussão sobre IA. Uma demonstração visual impressionante pode ser avaliada pela aparência; uma análise de vídeo precisa ser avaliada pela correspondência com o que realmente aconteceu. São critérios diferentes. Para uma aplicação que mede, conta ou acompanha processos, o erro pode estar em um detalhe pequeno que não altera a aparência geral da resposta.
Na leitura editorial, o avanço mais interessante seria tornar a análise verificável para quem a utiliza. Uma resposta acompanhada de momentos específicos de um vídeo permite conferir a evidência mais facilmente do que uma conclusão sem referência. Isso não elimina a possibilidade de erro, mas pode tornar a revisão humana mais rápida e direcionada.
Onde essa tecnologia pode encontrar aplicações
A Elorian apresenta exemplos relacionados à preparação de dados para robótica, descrição de vídeos e contagem de objetos. A empresa também deixa claro que controle direto de robôs e outras capacidades mais amplas continuam no horizonte de desenvolvimento. Assim, a prévia atual deve ser entendida como uma etapa de pesquisa e disponibilização, não como uma solução universal de autonomia física.
Para ilustrar a oportunidade, considere uma equipe que precisa organizar um arquivo de gravações. Hoje, a pergunta relevante pode não ser apenas qual objeto aparece, mas em que momento uma ação começa, quanto tempo dura e se volta a ocorrer. Uma ferramenta capaz de sugerir esses intervalos poderia ajudar a reduzir a busca manual. A utilidade dependeria da precisão nas condições reais do acervo.
Outro cenário possível é a revisão de demonstrações de tarefas. Quando alguém ensina uma sequência por vídeo, há informação em gestos, posições e mudanças de estado que pode ficar de fora de uma transcrição. Uma análise visual mais detalhada poderia auxiliar a organização desse material. Trata-se de uma possibilidade de aplicação, não de um resultado comercial já comprovado para o Glimpse.
O que os testes precisam demonstrar
O estágio de prévia pede uma avaliação cuidadosa das tarefas que interessam ao usuário. Um teste útil deve incluir cenas fáceis e difíceis, objetos parcialmente ocultos, mudanças de iluminação e perguntas cuja resposta não esteja claramente visível. Também importa observar se o sistema reconhece quando não há evidência suficiente, em vez de produzir uma conclusão aparentemente segura.
Uma comparação precisa considerar tempo de processamento, custo e quantidade de revisão necessária. Acertar uma tarefa após muitas tentativas pode servir a um experimento, mas não necessariamente a um fluxo de trabalho frequente. Da mesma forma, desempenho em exemplos selecionados não basta para estabelecer que o modelo é superior em todas as modalidades de visão computacional.
O próximo passo para o raciocínio visual
O Glimpse já pode ser explorado por meio dos canais de acesso anunciados pela Elorian. O valor dessa abertura está em permitir que desenvolvedores confrontem a proposta com problemas próprios, além das demonstrações escolhidas para o lançamento. A passagem de uma prévia promissora para uma aplicação confiável depende dessa avaliação em situações variadas.
Para o ecossistema de startups, a oportunidade é desenvolver ferramentas que interpretem melhor o conteúdo visual e entreguem uma resposta utilizável. Isso pode complementar iniciativas de infraestrutura para modelos de mundo, embora compreender vídeos e simular ambientes sejam problemas distintos. No caso do Glimpse, o que deve orientar a próxima fase é a capacidade de relacionar suas conclusões às evidências que o usuário consegue conferir.